FlowForge
Motor de automação por workflows em .NET, no estilo do n8n, feito para continuar correto quando alguma coisa falha no meio do caminho.
- Contexto
- Projeto pessoal
- Início
- Tipo
- Backend
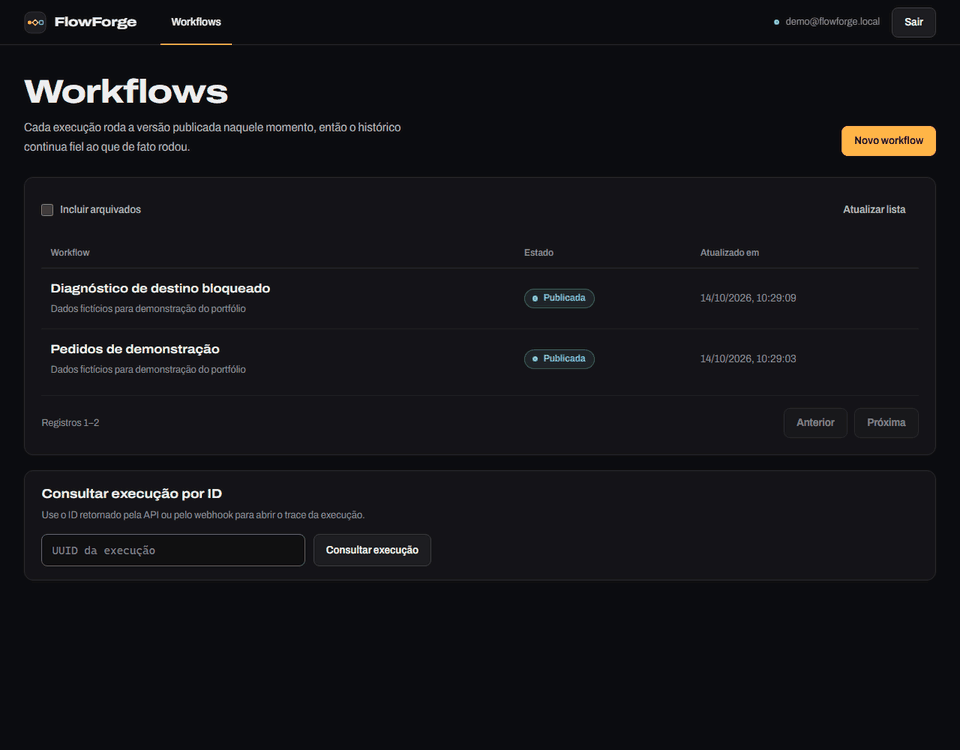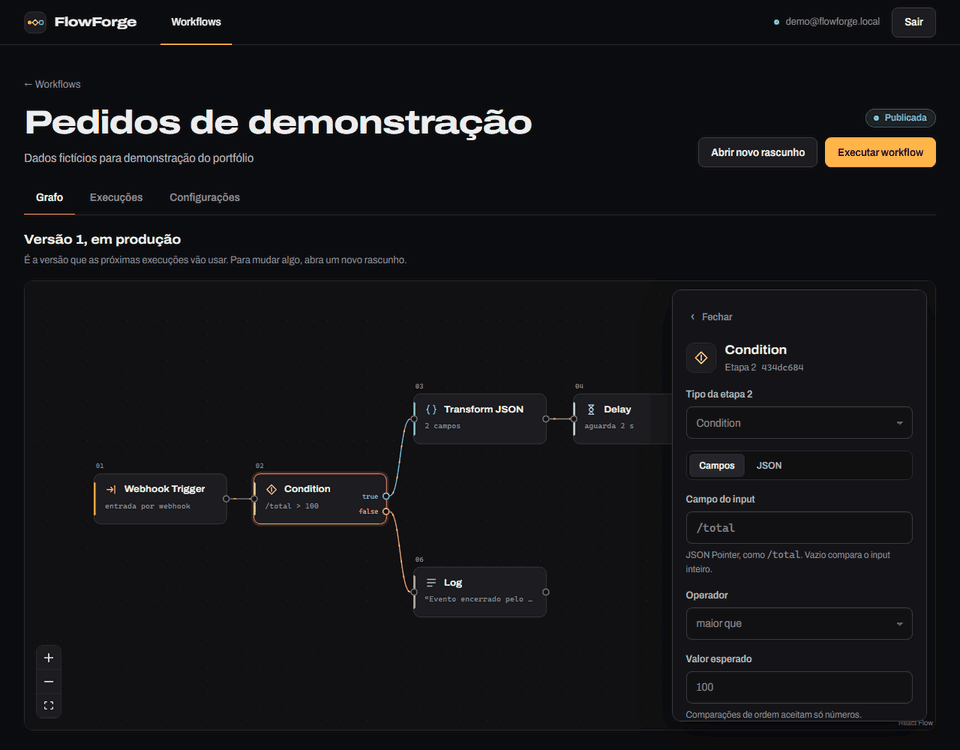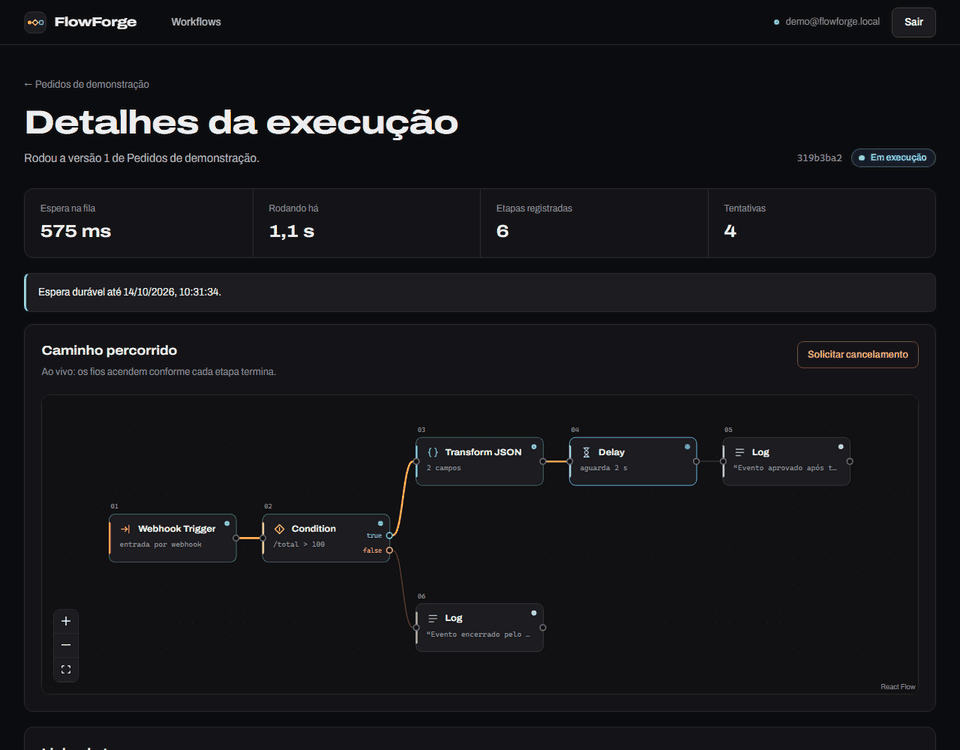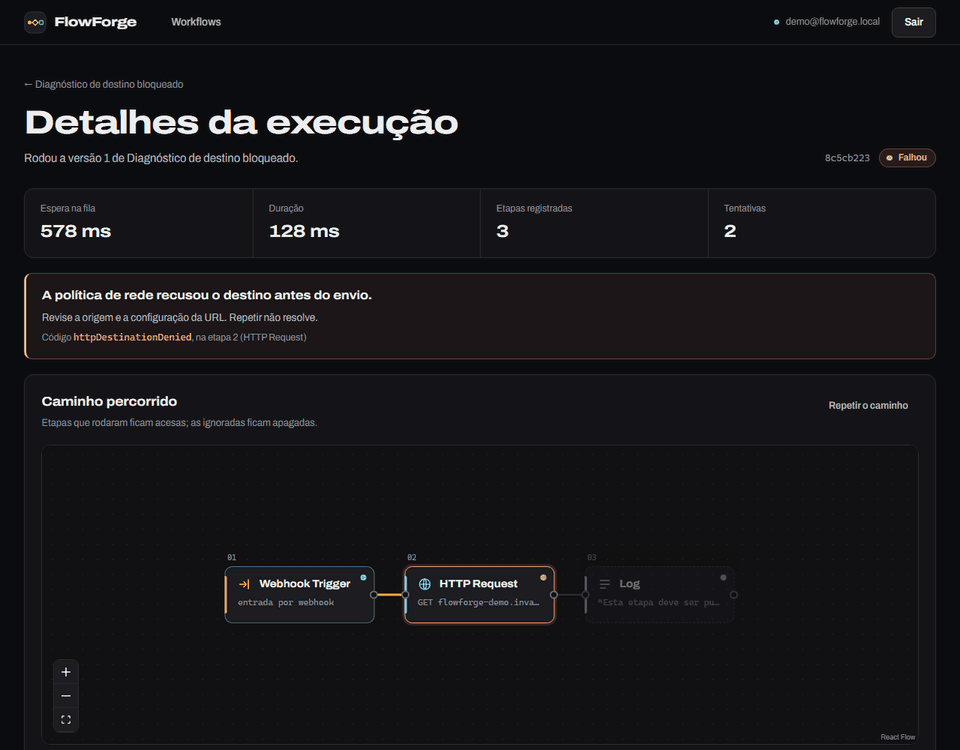
Em números
- endpoints HTTP
- 42
- testes em C#, de unidade a integração
- 361
- testes de ponta a ponta no navegador
- 38
- tabelas no PostgreSQL
- 18
- decisões de arquitetura registradas
- 17
- linha de teste para cada linha de código
- 1,1
Contado no código em out 2026.
Arquitetura
Por que eu fiz
No trabalho eu vivo cercado de automações: rotinas agendadas, integrações, títulos gerados a partir de outro sistema. Quase todo problema que aparece não é "a API não funciona", é "a API funcionou, mas alguma coisa caiu logo depois". Eu queria entender esse tipo de falha de verdade, e não só tratar com um try/catch.
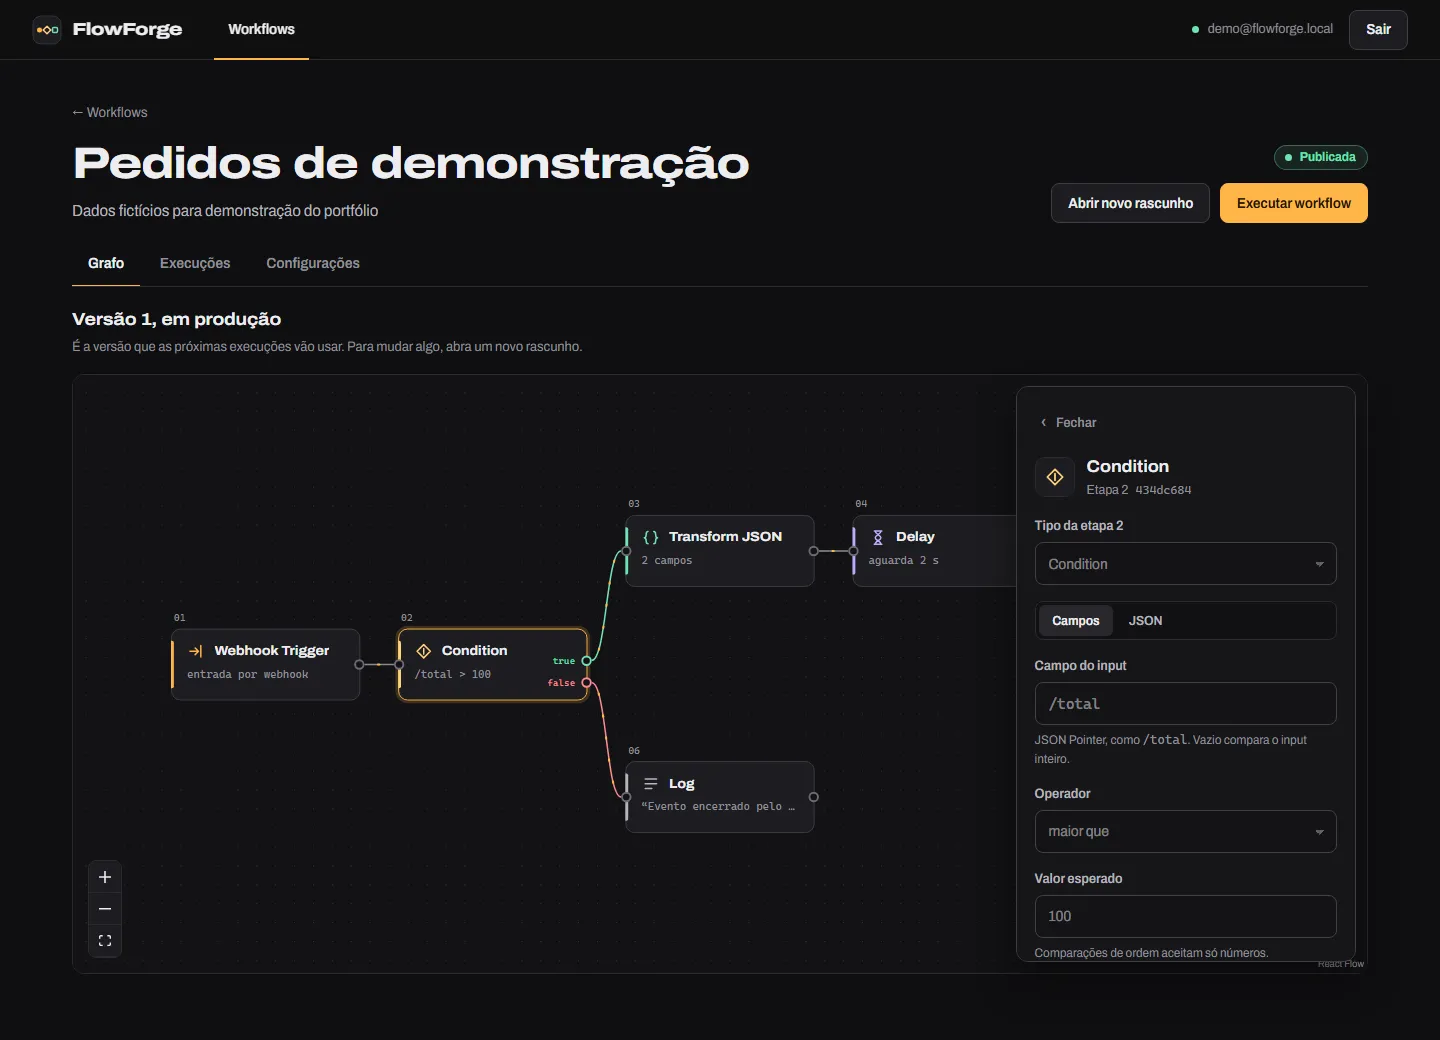
O FlowForge é a resposta que eu montei: você desenha um grafo, publica uma versão, e cada evento que chega por webhook vira uma execução independente, processada por um Worker com checkpoints, retry e recuperação depois de uma queda.
Como funciona por dentro
É um monólito modular com dois processos. A API recebe comandos e eventos e grava a execução e a mensagem de saída (outbox) na mesma transação do PostgreSQL. O Worker publica essa outbox no RabbitMQ, consome a fila e executa as etapas, gravando um checkpoint a cada passo. O PostgreSQL é a autoridade do estado; o RabbitMQ só transporta.
O que acontece quando algo dá errado
Cada um desses casos tem teste de integração rodando com PostgreSQL e RabbitMQ de verdade.
- O RabbitMQ está fora do ar quando o webhook chega: a API responde 202 mesmo assim, e o Worker publica quando o broker volta.
- O mesmo evento chega duas vezes ao mesmo tempo: a mesma Idempotency-Key devolve a mesma execução; corpo diferente com a mesma chave recebe 409.
- Um Worker trava e outro assume: um token de geração (fencing) impede o antigo de gravar por cima depois de perder a posse.
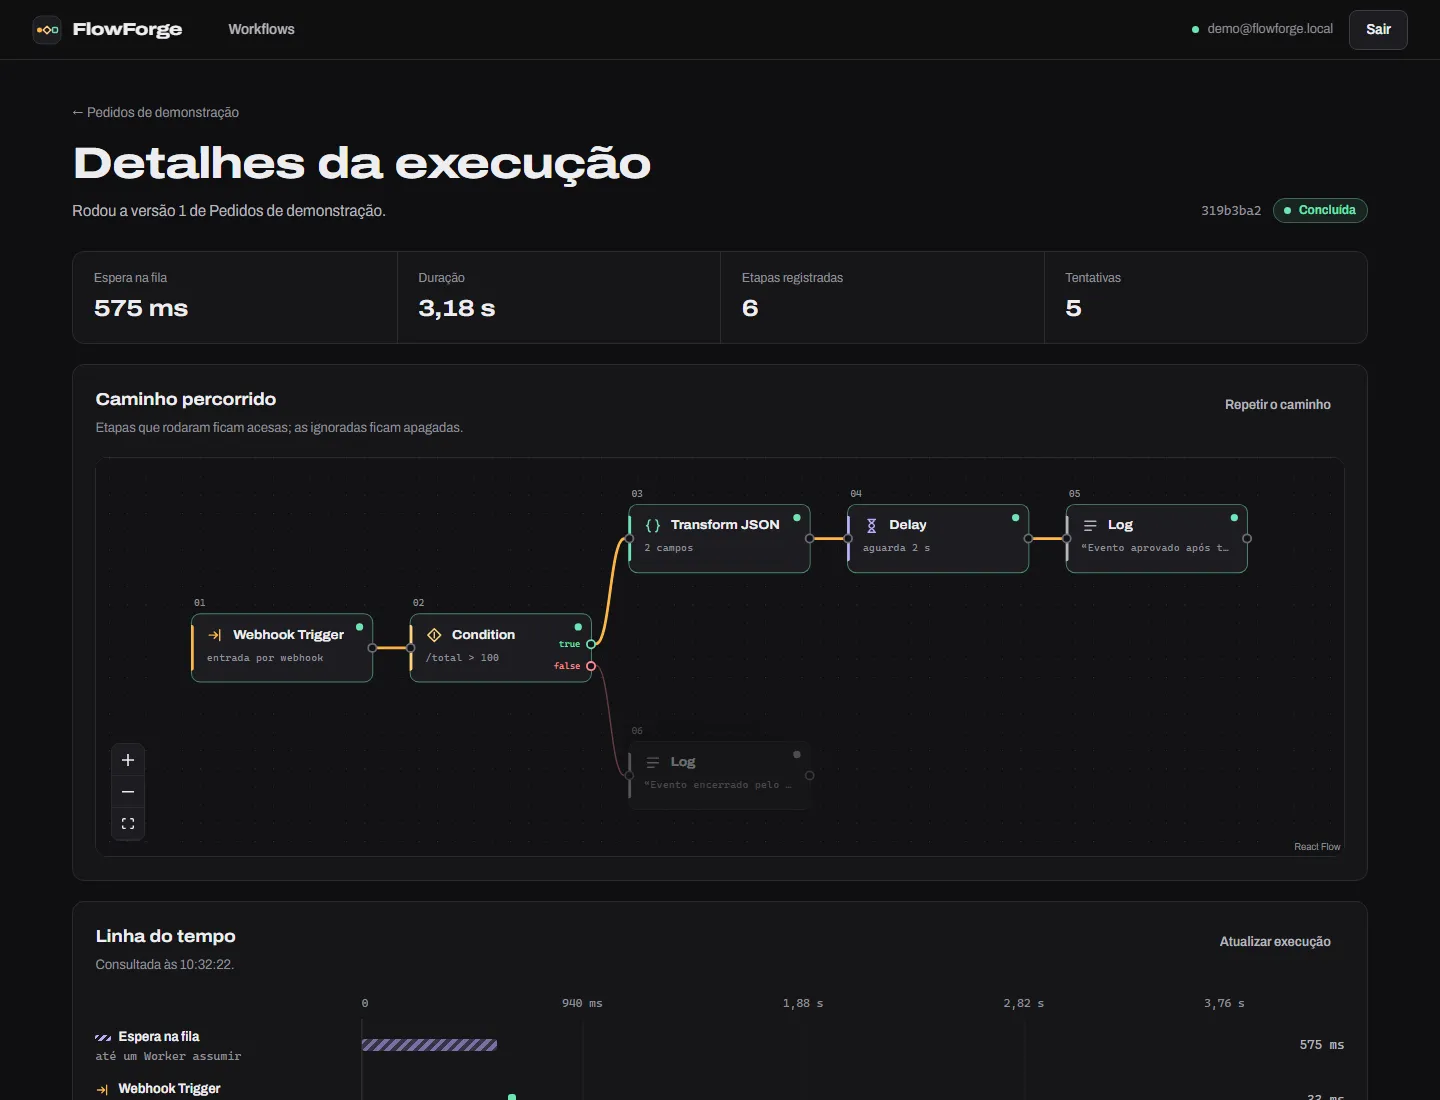
- O Worker cai depois de enviar um POST: o POST não é reenviado. A tentativa fica marcada com resultado externo desconhecido, em vez de fingir que nada aconteceu.
- Um Delay de horas está em andamento: a espera é estado no banco, não uma thread parada, e continua depois de um restart.
O que ele não promete
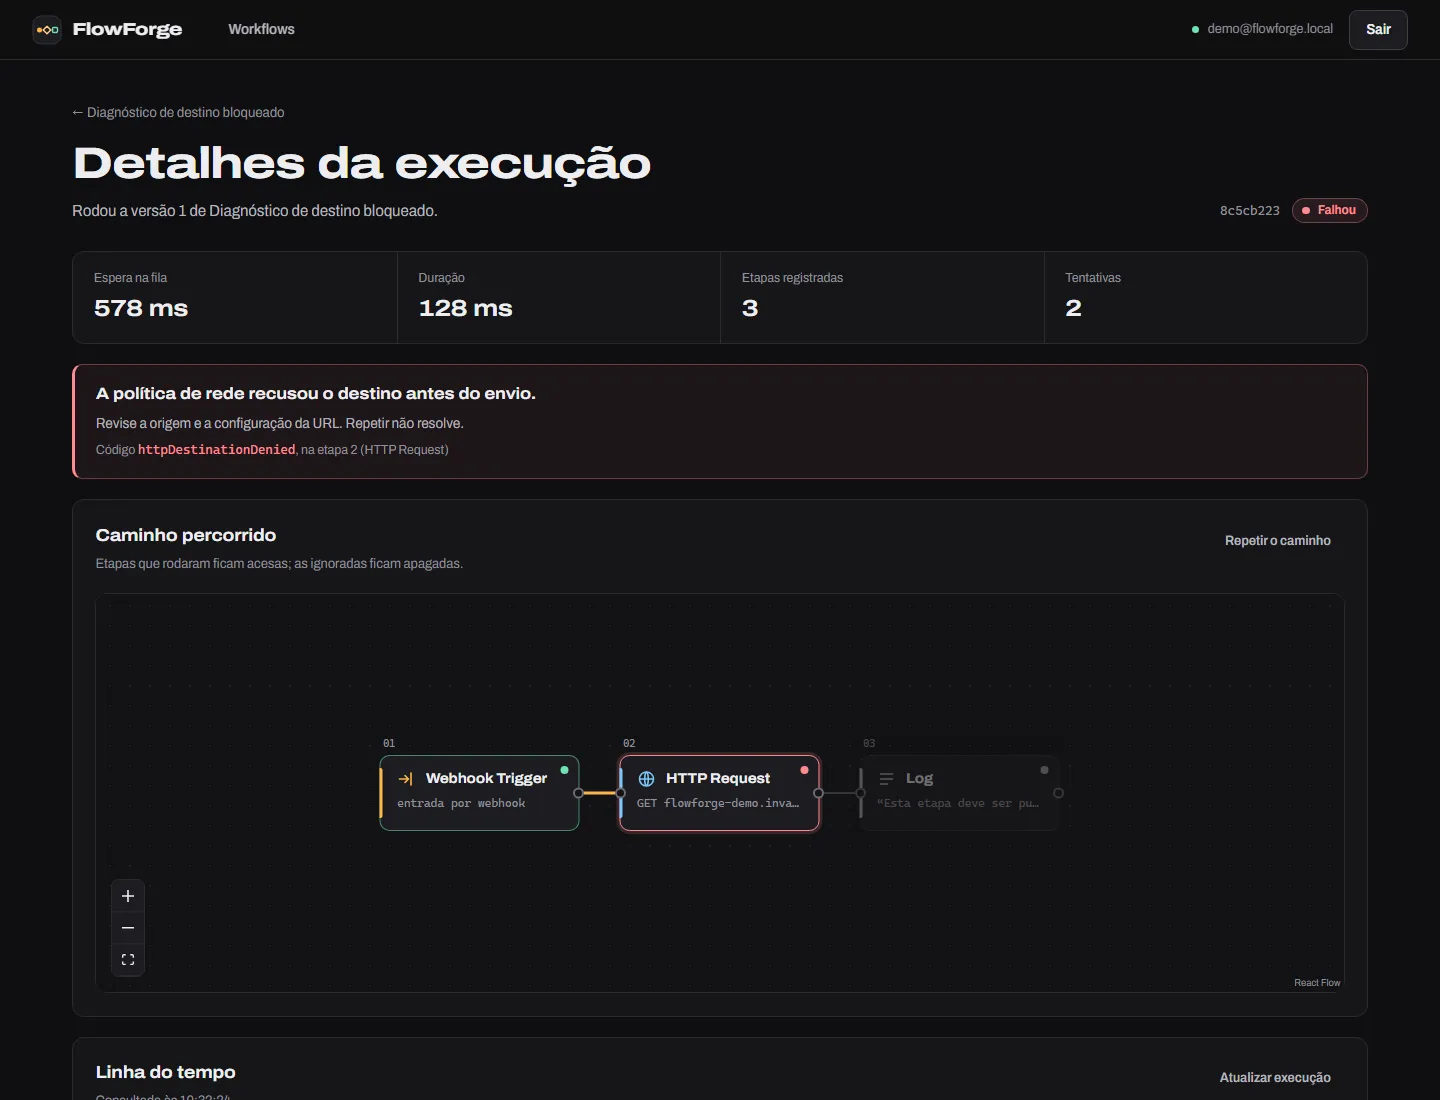
Não existe exactly-once em sistema externo, e eu preferi deixar isso claro. O FlowForge garante at-least-once com deduplicação local e mostra quando o efeito remoto é desconhecido. Retry só acontece no que é seguro repetir: métodos idempotentes ou destinos que aceitam Idempotency-Key.
Onde a IA entrou
Usei IA no processo, e ela me fez andar rápido. Mas foi revisando o que ela escrevia que eu mais aprendi: alguns dos casos acima eu só descobri porque uma revisão encontrou uma execução que ficava presa por horas.
Teste o FlowForge aqui mesmo
Este é o caminho que um evento faz dentro do FlowForge. Derrube a fila para ver os eventos esperando na outbox, ou mande o mesmo evento duas vezes.
Arraste para girar. Clique no Webhook para mandar um evento.Toque nos botões para mandar eventos e derrubar a fila.
Grafo 3D com seis etapas: Webhook, API, Outbox, RabbitMQ, Worker e Destino.
Registro